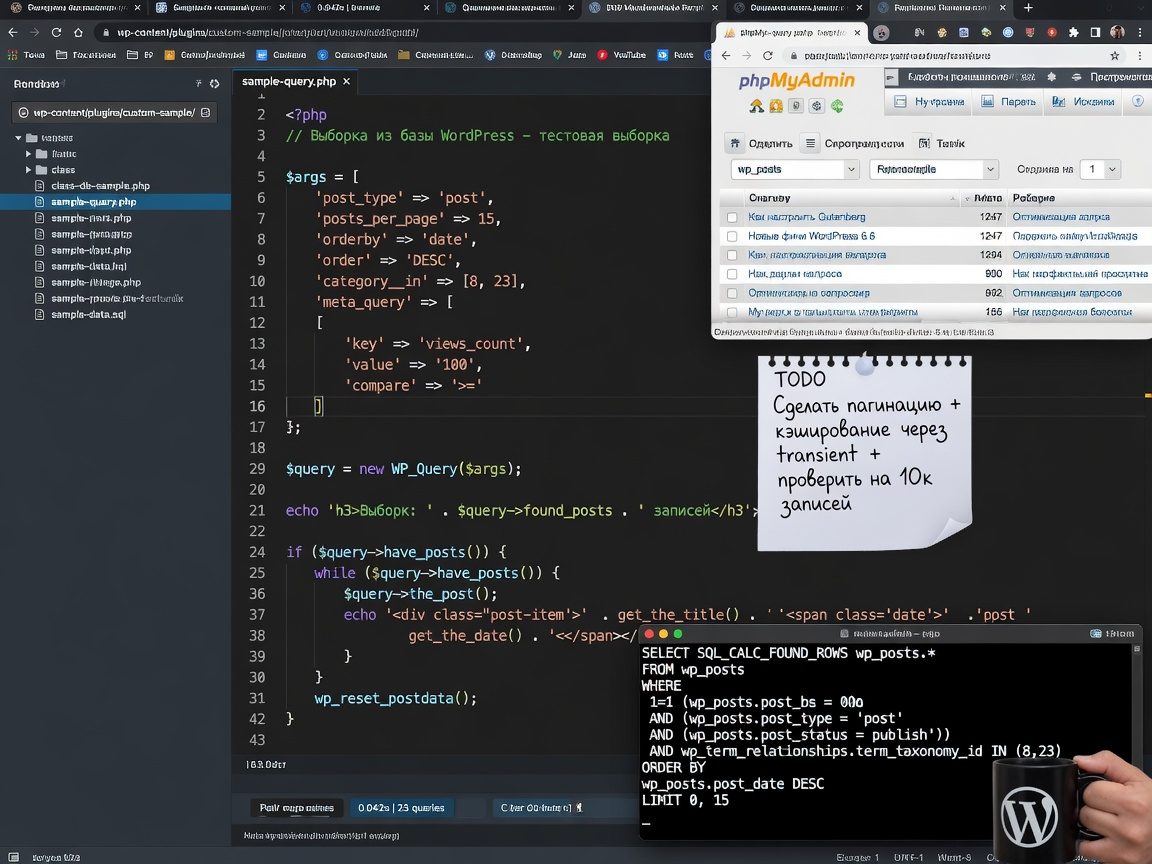
Что такое оптимизированный запрос к базе WordPress
Практически любой динамический сайт на WordPress постоянно обращается к базе данных.
Там находятся:
-
записи и страницы;
-
товары WooCommerce;
-
пользователи;
-
комментарии;
-
настройки;
-
произвольные поля;
-
таксономии;
-
метаданные;
-
данные плагинов.
Когда WordPress необходимо вывести последние статьи, получить настройки сайта или найти товары определённой категории, PHP-код в конечном счёте получает необходимые данные из базы.
Но одну и ту же задачу можно решить совершенно по-разному.
Например, условный запрос:
SELECT *
FROM wp_posts;
и:
SELECT ID, post_title
FROM wp_posts
WHERE post_type = 'post'
  AND post_status = 'publish'
ORDER BY post_date DESC
LIMIT 10;
могут обращаться к одной таблице, но выполняют принципиально разную работу.
Первый запрос просит базу вернуть все столбцы и все строки.
Второй ограничивает:
-
необходимые поля;
-
тип записи;
-
статус;
-
количество результатов;
-
порядок выборки.
Оптимизация запросов — это не попытка сделать SQL максимально коротким. Это сокращение ненужной работы базы данных, PHP и самого WordPress.
Особенно заметна разница на проектах с десятками и сотнями тысяч записей.
Почему не стоит выбирать все поля подряд
Одна из распространённых привычек при написании SQL:
SELECT *Разработчику это удобно: не требуется перечислять необходимые столбцы.
Но если для выполнения задачи нужны только:
ID
post_title
нет необходимости получать:
post_content
post_excerpt
post_password
post_mime_type
post_modified
guid
...
Что происходит при SELECT *
База возвращает больше данных.
Эти данные необходимо:
-
прочитать;
-
передать от СУБД приложению;
-
разместить в памяти PHP;
-
преобразовать в массивы или объекты;
-
затем значительную их часть просто не использовать.
Для нескольких строк разница может быть незаметна.
Для большой выборки она уже имеет значение.
Кроме того, выбор только необходимых столбцов в определённых запросах позволяет СУБД использовать covering index — покрывающий индекс. В таком случае необходимые данные могут быть получены непосредственно из индекса без чтения полной строки таблицы.
Как правильно работать с $wpdb
Например, вместо:
global $wpdb;

$results = $wpdb->get_results(
    "SELECT * FROM {$wpdb->posts}"
);
лучше сформулировать конкретную задачу:
global $wpdb;

$results = $wpdb->get_results(
    $wpdb->prepare(
        "SELECT ID, post_title
        FROM {$wpdb->posts}
        WHERE post_type = %s
        AND post_status = %s
        ORDER BY post_date DESC
        LIMIT %d",
        'post',
        'publish',
        10
    )
);
Такой запрос явно показывает, какие данные нужны приложению.
Но с WP_Query правило работает немного иначе
Здесь разработчики иногда допускают ошибку, пытаясь перенести возможности чистого SQL непосредственно в WP_Query.
У WP_Query есть параметр:
'fields'Но он не предназначен для произвольного перечисления любых столбцов wp_posts.
Стандартными вариантами являются:
'fields' => 'ids'или:
'fields' => 'id=>parent'Если мне нужны только идентификаторы записей, имеет смысл написать:
$query = new WP_Query(
    [
        'post_type'      => 'product',
        'posts_per_page' => 20,
        'fields'         => 'ids',
    ]
);
Вместо создания массива полноценных объектов WP_Post я получу массив ID.
Это особенно удобно, если идентификаторы нужны для последующей обработки.
Не отключайте кеши WP_Query без причины
У WP_Query существуют параметры:
'cache_results'
'update_post_meta_cache'
'update_post_term_cache'
Но устанавливать их в false при каждом запросе только потому, что кажется, будто так запрос станет быстрее, неправильно.
WordPress по умолчанию специально кеширует полученные объекты и предварительно загружает связанные metadata и taxonomy.
Это помогает избежать дополнительных обращений к базе позже.
Отключение может иметь смысл в специализированных запросах, когда разработчик точно знает, что соответствующие данные далее использоваться не будут.
Например, если мне нужен небольшой список заголовков и ссылок и я точно не буду обращаться к метаданным или терминам, можно рассмотреть:
$query = new WP_Query(
    [
        'post_type'              => 'post',
        'posts_per_page'         => 20,
        'update_post_meta_cache' => false,
        'update_post_term_cache' => false,
    ]
);
Но это именно оптимизация под конкретный сценарий, а не универсальная настройка для каждого WP_Query.
Используйте no_found_rows, когда не нужна пагинация
Ещё один полезный параметр:
'no_found_rows' => trueWordPress использует информацию об общем количестве найденных записей, чтобы рассчитать:
$query->found_posts;
$query->max_num_pages;
Это необходимо, например, для полноценной пагинации.
Но представим блок:
Последние 4 статьи
Нам не важно, существует в базе 200 или 200 000 статей. Нужны только четыре.
Можно написать:
$query = new WP_Query(
    [
        'post_type'      => 'post',
        'posts_per_page' => 4,
        'no_found_rows'  => true,
    ]
);
WordPress официально указывает, что включение no_found_rows позволяет пропустить подсчёт общего числа найденных строк и может повысить производительность.
Но использовать параметр нельзя бездумно: если после этого нужна информация о количестве страниц, её уже не будет.
Ограничивайте количество записей
Опасная конструкция:
'posts_per_page' => -1Иногда она действительно необходима.
Но использовать её как стандартный способ «получить всё» — плохая практика.
Представим каталог, в котором сегодня 50 товаров.
Запрос работает быстро.
Через два года там:
50 000 товаровИ старый код по-прежнему пытается загрузить их все.
Это означает:
-
большую выборку из БД;
-
дополнительную память PHP;
-
создание множества объектов;
-
обработку данных;
-
возможные дополнительные обращения к metadata.
Если интерфейсу одновременно нужны только 20 элементов, лучше получить 20.
Одна из главных ошибок — запрос внутри цикла
Рассмотрим условную архитектуру:
foreach ( $products as $product ) {
    // Выполнить дополнительный запрос.
}
Если основной запрос вернул 100 товаров, а внутри каждой итерации выполняется ещё один SQL-запрос, получается:
1 основной запрос
+
100 дополнительных
=
101 запрос
Это классическая проблема N+1.
При 1 000 элементах ситуация становится ещё хуже.
Что делать вместо этого
По возможности данные необходимо получать пакетно:
плохо:

товар 1 → запрос
товар 2 → запрос
товар 3 → запрос
товар 4 → запрос


лучше:

ID 1, 2, 3, 4
       ↓
один запрос
       ↓
все необходимые данные
Сам WordPress активно использует кеширование и cache priming именно для того, чтобы сократить количество повторяющихся обращений к базе.
Поэтому прежде чем писать собственный SQL внутри foreach, стоит проверить, нет ли подходящего WordPress API и не были ли необходимые данные уже загружены.
Осторожнее с postmeta и meta_query
Универсальность WordPress во многом обеспечивается таблицами метаданных.
Для записей используется:
wp_postmetaСтруктура позволяет сохранять:
post_id
meta_key
meta_value
Это невероятно удобно.
Например:
price
color
brand
rating
availability
можно хранить как metadata.
Но удобство не означает, что postmeta является идеальной заменой специализированной реляционной модели данных.
Где начинается проблема
Представим каталог с сотнями тысяч товаров и запрос:
цвет = чёрный
цена > 10000
бренд = Apple
в наличии = да
рейтинг >= 4
Сложный meta_query может потребовать нескольких соединений таблицы wp_postmeta с самой собой, сравнений meta_value, преобразования типов, сортировки и дополнительной фильтрации.
На больших объёмах данных стоимость таких запросов может существенно возрастать.
Поэтому при проектировании крупных систем важно задать вопрос:
действительно ли эти данные должны храниться в postmeta?
Для специализированных данных иногда правильнее создать отдельную таблицу с нормальной структурой и подходящими индексами.
Индексы базы данных: что это и зачем они нужны
Упрощённо индекс можно представить как указатель.
Без подходящего индекса СУБД в определённых ситуациях может быть вынуждена просматривать большое количество строк, чтобы найти необходимые данные.
С индексом она получает более эффективный путь поиска.
Представим таблицу:
orders

id
customer_id
status
created_at
total
Если постоянно выполняется запрос:
SELECT id, total
FROM wp_my_orders
WHERE customer_id = 125
  AND status = 'paid';
для такой модели может оказаться полезным составной индекс, учитывающий поля фильтрации.
Например:
KEY customer_status (customer_id, status)Но здесь нет правила:
Чем больше индексов, тем быстрее база.
Индекс:
-
занимает место;
-
требует обновления при INSERT;
-
требует обслуживания при UPDATE и DELETE;
-
должен соответствовать реальным запросам.
Поэтому индексы проектируют под фактическую структуру данных и характер обращений к ней.
Порядок полей составного индекса имеет значение
Индекс:
KEY customer_status (customer_id, status)и:
KEY status_customer (status, customer_id)не следует автоматически считать эквивалентными для всех запросов.
MySQL умеет использовать левую часть составного индекса.
Поэтому структуру индекса необходимо выбирать с учётом:
WHERE
JOIN
ORDER BY
GROUP BY
и реальной селективности данных.
Универсального индекса, который ускоряет любые запросы, не существует.
Не добавляйте индексы в стандартные таблицы WordPress вслепую
Можно встретить рекомендации вроде:
Просто добавьте несколько индексов в wp_postmeta, и WordPress станет быстрее.
Это слишком упрощённый подход.
Сначала необходимо определить конкретный медленный запрос и посмотреть его план выполнения.
Только после этого решать:
-
нужен ли дополнительный индекс;
-
можно ли изменить запрос;
-
стоит ли изменить модель хранения данных;
-
проблема вообще в SQL или находится выше — например, в PHP-коде.
Особенно осторожно я бы относился к модификации структуры стандартных таблиц WordPress ради устранения проблемы, которая на самом деле появилась из-за архитектуры конкретного шаблона или плагина.
Для собственных данных используйте собственные таблицы, когда это оправдано
WordPress не запрещает создавать дополнительные таблицы.
Например:
wp_project_orders
wp_project_statistics
wp_project_events
Для их создания и обновления схемы WordPress предоставляет dbDelta().
Преимущество собственной таблицы в том, что можно заранее определить:
PRIMARY KEY
KEY
UNIQUE KEY
под конкретную модель данных.
Например:
CREATE TABLE wp_project_events (
    id bigint unsigned NOT NULL AUTO_INCREMENT,
    user_id bigint unsigned NOT NULL,
    event_type varchar(50) NOT NULL,
    created_at datetime NOT NULL,

    PRIMARY KEY (id),
    KEY user_event (user_id, event_type),
    KEY created_at (created_at)
);
Если приложение постоянно работает с событиями именно таким образом, специализированная таблица может оказаться значительно логичнее хранения каждого свойства в отдельных строках metadata.
Но создавать собственную таблицу для каждого произвольного поля тоже не нужно. Решение должно приниматься исходя из характера данных, объёма и запросов.
Кеширование — один из главных способов разгрузить базу
Лучший оптимизированный запрос иногда тот, который вообще не пришлось выполнять.
Представим тяжёлую выборку:
Получить 10 популярных статей
за последние 30 дней
с дополнительными вычислениями
Если результат изменяется редко, нет необходимости пересчитывать его при каждом просмотре страницы.
Можно использовать кеш.
Object Cache
WordPress имеет WP_Object_Cache.
Например:
$items = wp_cache_get( 'popular_posts', 'theme' );

if ( false === $items ) {
    $items = my_expensive_query();

    wp_cache_set(
        'popular_posts',
        $items,
        'theme',
        HOUR_IN_SECONDS
    );
}
Но здесь существует важный нюанс.
Стандартный Object Cache WordPress по умолчанию не является постоянным между HTTP-запросами.
Для постоянного object cache обычно используется дополнительный backend, например Redis или Memcached.
Transients API
Для данных, которые нужно временно сохранить независимо от наличия persistent object cache, WordPress предоставляет Transients API.
Пример:
$items = get_transient( 'theme_popular_posts' );

if ( false === $items ) {
    $items = my_expensive_query();

    set_transient(
        'theme_popular_posts',
        $items,
        HOUR_IN_SECONDS
    );
}
Без persistent object cache transient обычно хранится через базу данных.
При наличии соответствующего persistent object cache WordPress может хранить его уже во внешнем кеширующем backend.
Поэтому Redis и Transients — не обязательно взаимоисключающие механизмы.
Важная особенность Transients
Время expiration следует воспринимать как максимальный срок жизни, а не гарантию того, что значение обязательно сохранится до указанной секунды.
Кеш может исчезнуть раньше.
Поэтому код всегда должен уметь заново получить исходные данные:
есть кеш?
   ↓
 ДА → использовать
   ↓
 НЕТ
   ↓
получить данные
   ↓
сохранить кеш
   ↓
вернуть результат
Не забывайте об инвалидации кеша
Создать кеш — половина задачи.
Необходимо понимать, когда его удалить.
Например, мы кешируем список:
5 популярных товаров
После изменения данных товара кеш может стать устаревшим.
Следовательно, необходимо либо:
delete_transient( 'popular_products' );в подходящий момент, либо использовать разумный срок жизни кеша.
Одна из распространённых ошибок — кешировать тяжёлый запрос и совершенно не продумать обновление результата.
Оптимизируйте структуру SQL-запроса
Количество запросов — не единственная характеристика производительности.
Два сайта могут выполнять по 50 SQL-запросов на страницу, но первый работает быстро, а второй медленно.
Причина — стоимость каждого запроса.
Особого внимания требуют:
-
большие
JOIN; -
сложные
meta_query; -
LIKE '%text%'; -
сортировка больших выборок;
-
GROUP BY; -
DISTINCT; -
ненужные подзапросы;
-
выборка огромного количества строк;
-
условия по неиндексированным столбцам;
-
сортировка по вычисляемым значениям.
Поэтому цель:
не минимальное число SQL-запросов любой ценой, а минимальный объём ненужной работы.
Иногда два простых и хорошо кешируемых запроса могут оказаться разумнее одного гигантского SQL-монстра.
LIMIT — не мелочь
Если интерфейс показывает:
8 товаровне нужно сначала получать 5 000 товаров, чтобы PHP затем оставил первые восемь.
Ограничение должно происходить как можно ближе к источнику данных:
LIMIT 8А в WP_Query:
'posts_per_page' => 8Это кажется очевидным, но в реальных шаблонах всё ещё встречается логика:
получить всё
↓
отфильтровать PHP
↓
array_slice()
↓
показать несколько элементов
Так база, сеть между PHP и СУБД и сам PHP выполняют ненужную работу.
Не сортируйте в PHP то, что эффективнее сделать в базе
Похожая ошибка:
SELECT данные
↓
получить тысячи строк
↓
usort()
↓
выбрать первые 10
Если данные нормально моделированы и запрос может использовать подходящий индекс, зачастую лучше поручить эту задачу базе:
ORDER BY created_at DESC
LIMIT 10
СУБД специально предназначена для поиска, фильтрации и сортировки данных.
Используйте WordPress API, а прямой SQL — когда он действительно нужен
Не стоит воспринимать:
$wpdbкак «более быстрый WP_Query».
WP_Query предоставляет намного больше, чем просто генерацию SQL:
-
взаимодействие с WordPress API;
-
кеширование;
-
фильтры;
-
работу с объектами;
-
metadata cache;
-
taxonomy cache;
-
совместимость с экосистемой.
Если нужно получить обычные записи WordPress, чаще правильнее начать с WP_Query.
$wpdb становится особенно полезен, когда:
-
используется собственная таблица;
-
нужен специализированный агрегирующий запрос;
-
стандартный API плохо соответствует задаче;
-
требуется конкретная SQL-операция.
Никогда не забывайте про $wpdb->prepare()
Оптимизация не должна происходить за счёт безопасности.
Плохо:
$sql = "
    SELECT ID
    FROM {$wpdb->posts}
    WHERE post_author = " . $_GET['author'];
Правильно использовать подготовленный запрос:
$sql = $wpdb->prepare(
    "SELECT ID
    FROM {$wpdb->posts}
    WHERE post_author = %d",
    $author_id
);
wpdb::prepare() поддерживает placeholders для строк, целых чисел, чисел с плавающей точкой и идентификаторов.
Это прежде всего вопрос защиты от SQL injection и корректного формирования запросов.
Как понять, какой запрос действительно медленный
Оптимизировать SQL «на глаз» — плохая практика.
Сначала необходимо найти проблему.
Для WordPress одним из наиболее полезных инструментов является Query Monitor.
Он позволяет анализировать:
-
запросы к БД;
-
время выполнения;
-
повторяющиеся запросы;
-
запросы конкретной темы;
-
запросы плагинов;
-
hooks;
-
HTTP API;
-
PHP errors.
Это особенно удобно при разработке собственного шаблона.
Можно открыть страницу и обнаружить, например:
Всего: 147 запросов

Theme:
92 запроса

Plugin A:
20 запросов

WordPress Core:
35 запросов
После этого уже имеет смысл искать причину 92 запросов темы.
WordPress официально рекомендует Query Monitor как debugging-инструмент для анализа запросов и производительности.
SAVEQUERIES — полезно, но только при отладке
WordPress также поддерживает:
define( 'SAVEQUERIES', true );После этого информация о запросах становится доступна через:
$wpdb->queriesМожно увидеть запрос, время выполнения и источник вызова.
Но SAVEQUERIES сам создаёт дополнительную нагрузку.
Поэтому WordPress прямо рекомендует отключать его после диагностики.
На production постоянно держать:
SAVEQUERIES = trueне стоит.
Используйте EXPLAIN для тяжёлых SQL-запросов
Когда найден конкретный медленный SQL:
SELECT ...
FROM ...
WHERE ...
ORDER BY ...
следующий полезный инструмент — EXPLAIN.
Например:
EXPLAIN
SELECT id, total
FROM wp_project_orders
WHERE customer_id = 125
AND status = 'paid';
План выполнения помогает понять:
-
какие таблицы участвуют;
-
какие индексы доступны;
-
какой индекс выбран;
-
сколько строк предполагается обработать;
-
каким способом выполняется соединение и поиск.
Это гораздо надёжнее предположения:
Наверное, сюда нужно добавить индекс.
Какие ошибки допускают разработчики WordPress-шаблонов
На практике проблемы с базой данных часто появляются не в WordPress Core, а непосредственно в теме или кастомном функционале.
Вот наиболее типичные ошибки:
-
WP_Queryвнутри циклов. Один запрос порождает десятки или сотни дополнительных. -
posts_per_page => -1без реальной необходимости. Пока данных мало, проблема незаметна. -
Получение полных объектов, когда нужны только ID. В подходящих сценариях можно использовать
fields => 'ids'. -
Ненужный подсчёт общего количества записей. Для блоков без пагинации можно рассмотреть
no_found_rows => true. -
Сложные
meta_queryкак универсальная база данных. Особенно опасно на больших каталогах и проектах с огромнойwp_postmeta. -
Отсутствие кеширования дорогих вычислений. Одинаковая тяжёлая выборка выполняется при каждом запросе страницы.
-
Неправильное кеширование. Кеш создаётся, но его инвалидация не продумана.
-
SELECT *в собственных SQL-запросах. Приложение получает данные, которые ему вообще не нужны. -
Отсутствие LIMIT. PHP получает тысячи строк ради вывода нескольких элементов.
-
Отсутствие индексов в собственных таблицах. Таблица растёт, а структура остаётся рассчитанной на первые сто записей.
-
Добавление индексов наугад. Индексы создаются без анализа реальных запросов и
EXPLAIN. -
SQL вместо WordPress API без необходимости. Разработчик обходит механизмы кеширования и стандартную архитектуру WordPress ради сомнительной микрооптимизации.
-
Фильтрация больших массивов средствами PHP. Из БД извлекается огромный набор, после чего большая часть выбрасывается.
-
Повторное получение одних и тех же данных. Один шаблон несколько раз выполняет практически идентичные запросы.
-
Отсутствие профилирования. Разработчик оптимизирует то, что кажется медленным, вместо измерения реального bottleneck.
Как должен выглядеть оптимизированный подход
Если сильно упростить, при разработке я придерживался бы следующей последовательности:
Что именно мне нужно получить?
              ↓
Можно использовать WordPress API?
              ↓
Ограничить количество результатов
              ↓
Не получать лишние данные
              ↓
Нужен ли подсчёт общего количества?
              ↓
Нужны ли metadata и taxonomy?
              ↓
Можно ли кешировать результат?
              ↓
Соответствуют ли индексы запросу?
              ↓
Query Monitor / slow query log
              ↓
EXPLAIN для проблемного SQL
              ↓
Измерить результат после оптимизации
Последний пункт особенно важен.
Если после «оптимизации» время выполнения практически не изменилось, возможно, проблема была совсем не там.
Оптимизация базы начинается с архитектуры
Главная ошибка — воспринимать оптимизацию SQL как работу, которая начинается после появления медленного сайта.
На самом деле она начинается во время проектирования.
Разработчик заранее определяет:
-
какие данные будут храниться;
-
насколько быстро они будут расти;
-
как часто их читают;
-
как часто изменяют;
-
по каким полям фильтруют;
-
по каким сортируют;
-
какие данные можно кешировать;
-
подходят ли для них стандартные сущности WordPress.
Для сайта с 30 страницами некоторые ошибки никогда не станут заметны.
Для WooCommerce-магазина с десятками тысяч товаров тот же подход может превратиться в серьёзную проблему.
Вывод
Оптимизация запросов WordPress — это не набор магических параметров для WP_Query.
Это правильная работа с данными на нескольких уровнях.
Если мне нужны только идентификаторы — нет смысла получать полные объекты. Если на странице выводится восемь товаров — не нужно загружать восемь тысяч. Если результат дорогого запроса меняется раз в час — нет необходимости вычислять его при каждом просмотре. Если собственная таблица содержит миллионы строк — её индексы должны соответствовать реальным запросам.
И главное: оптимизировать нужно после измерений, а не на основании догадок.
Query Monitor, профилирование, slow query log и EXPLAIN позволяют найти реальную причину нагрузки. А правильная архитектура WP_Query, $wpdb, кеширования, metadata и собственных таблиц помогает сделать так, чтобы эта нагрузка изначально не появилась.
Хорошо оптимизированный WordPress — это не сайт, который выполняет минимально возможное количество запросов.
Это сайт, в котором каждый запрос выполняет действительно необходимую работу.